Lecture : 9 minutes · Niveau : débutant à intermédiaire
À quoi sert le DataLayer ?
Le DataLayer est une couche de données située entre l’interface du site et les outils qui doivent observer ses interactions. Au lieu de demander à chaque outil de deviner ce qu’un clic signifie dans le HTML, le site pousse un message explicite. Le gestionnaire de tags peut ensuite écouter ce message.
Cette séparation réduit la dépendance aux classes CSS, rend la collecte lisible dans un outil de prévisualisation et permet de tester le contrat de données avant de configurer GA4. Le DataLayer n’est donc pas un reporting : c’est une interface de transmission.
Un contrat entre le site et la mesure
Un contrat de données répond à des questions simples : quel événement est envoyé, à quel moment, avec quelles clés et dans quel format ? Si un développeur renomme item_id en product_code sans prévenir, la balise peut continuer à se déclencher tout en envoyant une donnée vide. Le problème devient alors invisible dans l’interface du site.
Documenter le contrat dans un plan de marquage évite cette situation. Pour chaque événement, on indique le déclencheur, le payload attendu, l’outil destinataire, la fréquence et le test de recette.
Événement, paramètre et objet
Le DataLayer est souvent présenté comme un objet technique réservé aux développeurs. C’est pourtant d’abord une histoire de vocabulaire : nommer correctement ce qui se passe dans un parcours.
Un événement dit ce qui s’est passé. Les paramètres disent dans quel contexte.
Un événement, puis son contexte
Quand un étudiant ajoute le Kit Tracking au panier, KIDDL pousse un événement add_to_cart. Cet événement ne suffit pas à savoir quel produit a été choisi. L’objet ecommerce.items[] apporte le contexte.
On peut alors distinguer :
- l’événement :
add_to_cart; - le produit :
item_idetitem_name; - la quantité et la valeur :
quantityetprice.
Contrôler la qualité du signal
Lire le DataLayer ne consiste pas seulement à vérifier que quelque chose apparaît dans la console. Il faut contrôler le moment, la fréquence, la structure et la cohérence. Un événement envoyé deux fois peut gonfler un taux. Un événement envoyé avant le choix de consentement peut modifier le périmètre mesuré. Un événement sans identifiant produit empêche de comparer les kits.
| Contrôle | Question | Risque |
|---|---|---|
| Nom | Est-il conforme à la convention ? | Déclencheur non activé |
| Moment | Arrive-t-il après l’action réelle ? | Conversion anticipée |
| Fréquence | Une fois par action ? | Doublons et taux gonflés |
| Structure | Les clés sont-elles stables ? | Paramètres absents |
| Consentement | Le choix est-il respecté ? | Mesure incomplète |
Google Analytics recommande des noms e-commerce comme view_item, add_to_cart, begin_checkout et purchase. Cette convention facilite l’analyse, mais elle ne dispense pas de documenter les paramètres attendus. Un purchase envoyé deux fois avec le même identifiant peut créer un problème de déduplication. Une actualisation de la page de confirmation doit donc faire partie de la recette.
Construire un atelier KIDDL
KIDDL donne aux étudiants un terrain de test sans données personnelles réelles. Ils peuvent afficher window.dataLayer, réaliser une action et comparer le message reçu avec le plan de marquage.
Le premier exercice consiste à relier les étapes : view_item_list pour le catalogue, view_item pour l’intérêt, add_to_cart pour la sélection, puis begin_checkout, purchase et download_resources. Le deuxième demande de relever les clés de trois payloads. Le troisième demande de trouver une anomalie ou une limite d’interprétation.
Lire avant de configurer
La console du navigateur permet de vérifier le signal produit par le site. Cette étape évite de créer dans GTM des variables basées sur une hypothèse. On observe d’abord la clé exacte, sa structure et le moment où elle apparaît.
Ensuite seulement, on crée le déclencheur d’événement personnalisé et la balise GA4. Le Kit DataLayer propose un exemple volontairement court pour pratiquer cette lecture.
Le parcours comme fil conducteur
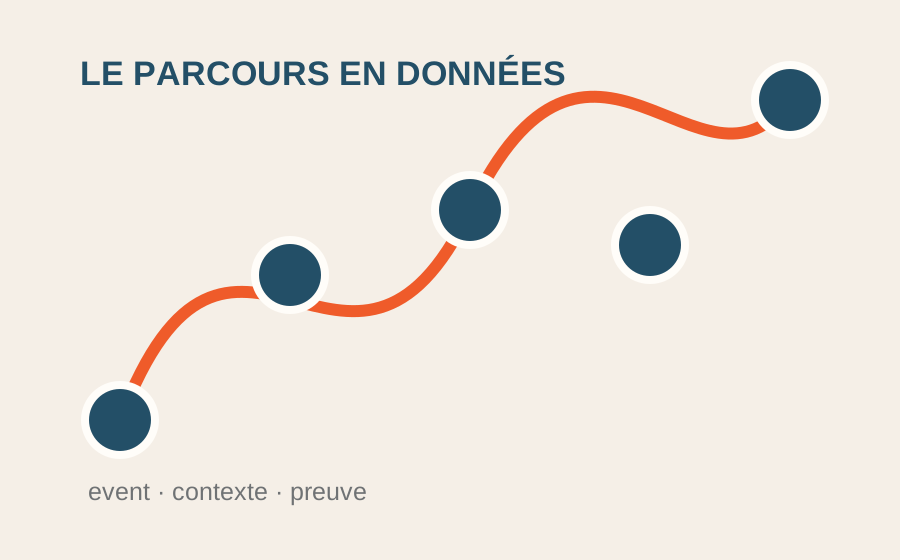
Un site ne mesure pas une collection d’événements indépendants. Il mesure une succession d’étapes : arrivée, intérêt, panier, tunnel, commande et téléchargement. La cohérence entre ces étapes est plus utile qu’une longue liste d’événements isolés.
Le KPI associé doit ensuite reprendre ce parcours pour transformer les événements en question d’analyse.
La dernière étape est la transmission à GTM puis à GA4. Dans GTM, on crée un déclencheur sur le nom de l’événement, puis des variables Data Layer pour récupérer les valeurs. Dans la balise GA4, on transmet les paramètres attendus. Le test doit être fait en mode Preview, puis dans DebugView, car un événement visible dans le navigateur peut être bloqué, transformé ou mal paramétré plus loin.
Le consentement ajoute une limite importante. Google décrit Consent Mode comme un mécanisme qui adapte le comportement des balises au choix de l’utilisateur et peut utiliser la modélisation pour compléter certaines mesures. Cela ne signifie pas que les données refusées deviennent identiques aux données consenties. Il faut documenter le périmètre réellement observable.
Le rôle de GTM n’est pas de réparer un mauvais contrat
Un gestionnaire de tags sait écouter un événement et transmettre des paramètres, mais il ne peut pas deviner une information qui n’existe pas. Si l’équipe veut comparer les kits par niveau, le DataLayer doit fournir un niveau ou une catégorie. Si elle veut distinguer une fiche vue d’un clic d’ajout, les deux actions doivent avoir des événements distincts. Une configuration complexe ne compense jamais une définition floue.
Cette idée est importante en atelier, car les étudiants commencent souvent par chercher le bon bouton dans GTM. Le bon réflexe est inverse : écrire l’action métier, préciser la donnée attendue, puis seulement choisir le déclencheur et la balise. Le plan de tag devient ainsi un document de dialogue entre marketing, produit et technique.
Les erreurs de structure les plus courantes
- utiliser des noms différents selon les pages ;
- envoyer une valeur sous forme de texte sur une page et de nombre sur une autre ;
- mettre les produits dans des clés différentes selon l’événement ;
- oublier de vider un ancien objet e-commerce avant un nouvel événement ;
- déclencher une conversion sur un clic alors que l’action réelle arrive plus tard.
Ces erreurs sont difficiles à voir dans un rapport agrégé. Elles apparaissent plus facilement lorsqu’on observe chaque message dans GTM Preview. Le test doit donc commencer par un petit parcours reproductible, avec un seul kit, un seul appareil et un scénario écrit.
Une méthode de recette en cinq questions
Pour chaque événement KIDDL, l’étudiant peut répondre à cinq questions : quelle action l’a déclenché ? Est-il arrivé une seule fois ? Quelles clés sont présentes ? Les valeurs correspondent-elles à l’écran ? Que doit faire l’outil suivant ? Cette grille transforme une capture d’écran en preuve de fonctionnement.
La recette doit également prévoir les cas négatifs. Que se passe-t-il si le visiteur refuse le consentement ? Que se passe-t-il s’il ferme le panier ? Que se passe-t-il s’il recharge la confirmation ? Un tracking professionnel ne décrit pas seulement le scénario heureux. Il documente aussi les situations où une donnée ne doit pas être envoyée ou ne doit pas être comptée deux fois.
Enfin, le DataLayer est une source de vérité opérationnelle, pas une vérité sur le comportement humain. Il indique qu’un événement a été produit par le site. Il ne dit pas pourquoi l’utilisateur a cliqué, s’il a compris la promesse ou s’il a réellement trouvé la ressource utile. Ces questions nécessitent d’autres méthodes : entretien, test utilisateur, questionnaire ou analyse qualitative.
Une bonne documentation garde aussi la version du plan. Le site évolue : un bouton peut devenir un lien, le tunnel peut être raccourci, ou une ressource peut être regroupée dans un pack. Sans date et sans responsable, une capture ancienne peut être prise pour la configuration actuelle. Le support KIDDL associe donc chaque événement à un scénario de test et à une date de vérification.
Cette version du plan doit être relue à chaque évolution du parcours, car la qualité du tracking dépend autant de la maintenance que de la première configuration.
Cette grille est conçue pour être réutilisée en atelier et dans un contexte professionnel. Elle aide à distinguer le fait observé, le calcul choisi, l’hypothèse formulée et la décision proposée. En documentant également la source, la date et la limite, l’équipe produit un contenu plus fiable, plus facile à relire et plus utile pour les personnes qui doivent agir.